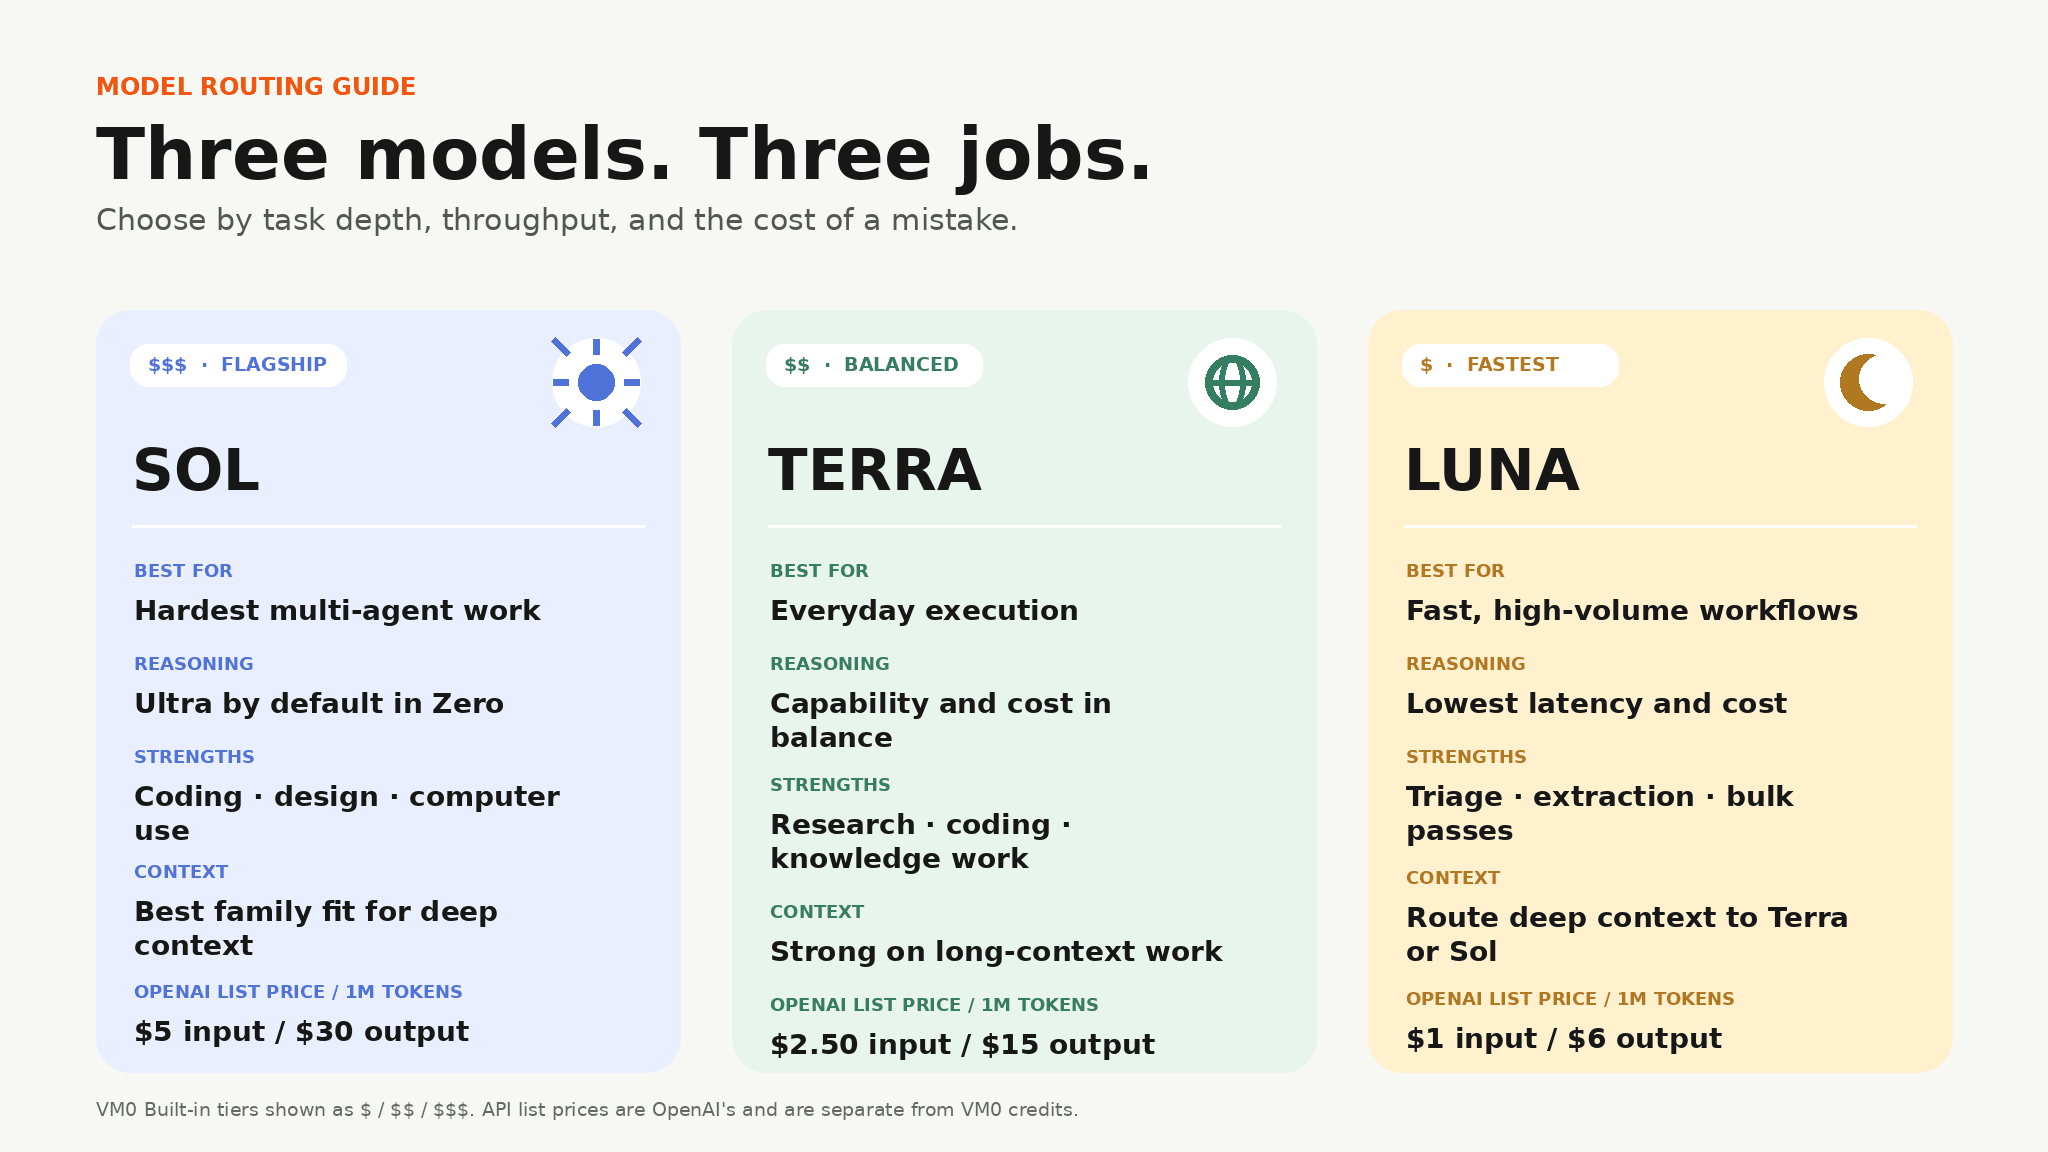
GPT-5.6 现已作为三模型系列内置于 Zero:Sol 适用于最复杂的多智能体任务,Terra 适用于均衡的日常执行,Luna 适用于快速、高吞吐量的工作流。
对于需要调度多样化智能体工作负载的团队而言,这往往比单一新旗舰模型更实用。无需在每个步骤都为最强推理能力付费,你可以根据任务匹配合适的模型,同时保持 Zero 环境的一致性:连接的工具、文件、浏览器访问、隔离执行、技能以及全程跟进。
选择内置路由,VM0 将管理模型访问并以积分计费。如果你的团队已使用 OpenAI API 密钥或 ChatGPT/Codex 订阅,Zero 同样支持这些路由方式。
同一系列,三个运行点
OpenAI 围绕持久能力分层设计了 GPT-5.6。数字标识代次;Sol、Terra 和 Luna 描述了智能、速度与成本之间的权衡。
GPT-5.6 Sol:应对最艰难的任务
Sol 是旗舰模型。当一项任务足够复杂,更强的规划、更多的检验或并行处理能够实质性地改变结果时,请选择它。
Zero 的 GPT-5.6 Sol 集成默认使用 Ultra 推理模式。OpenAI 将 Ultra 描述为并行协调四个智能体,再综合其工作成果。这使 Sol 非常适合包含多个独立工作流的任务,例如:
- 迁移大型代码库,同时测试兼容性并记录结果。
- 跨多个来源研究市场,对发现提出质疑,并生成可供决策的简报。
- 将产品简报转化为精致的界面,检查渲染结果,并修复视觉或功能问题。
- 在日志、代码、工单和浏览器状态中排查生产事故,再提出修复方案。
Sol 对应 VM0 内置层级中的 $$$。请将其用于出错代价高昂的场景,而非每一个简短回复。
GPT-5.6 Terra:均衡的主力模型
Terra 是可重复专业工作的合理起点。OpenAI 将其定位为均衡层级,并报告其性能与 GPT-5.5 相当,而 API 标价仅为后者的一半。
将 Terra 用于仍需推理和工具调用、但不需要 Sol 最大算力的工作:
- 日常研究、竞争对手监控和多来源摘要。
- 常规代码变更、拉取请求分析和问题排查。
- 起草报告、发布计划、客户简报和运营文档。
- 需要强大长上下文处理能力、但成本要求更适中的智能体工作流。
Terra 对应 VM0 内置层级中的 $$。它并非被强制设为通用默认值,只是我们在许多通用工作流中会首先测试的层级。
GPT-5.6 Luna:速度与规模
Luna 是该系列中速度最快、成本最低的成员。它专为吞吐量和响应时间比最大深度更重要的场景而设计。
适合 Luna 的工作负载包括:
- 对大批量工单、线索或消息进行分类或路由。
- 从格式一致的文档中提取结构化字段。
- 在将模糊案例提升至 Terra 或 Sol 之前进行初步分类。
- 大批量生成简短摘要或执行转换操作。
Luna 对应 VM0 内置层级中的 $。它并非所有低成本任务的最佳选择:OpenAI 自身的长上下文评估显示,在超大输入的检索任务上,Luna 与另外两个更大层级之间存在显著差距。请将深度、模糊的上下文路由至 Terra 或 Sol。
基准测试能说明什么——又不能说明什么
OpenAI 报告了该系列的强劲成绩,但真正有价值的信息是权衡关系的形态,而非单一的排行榜位置。
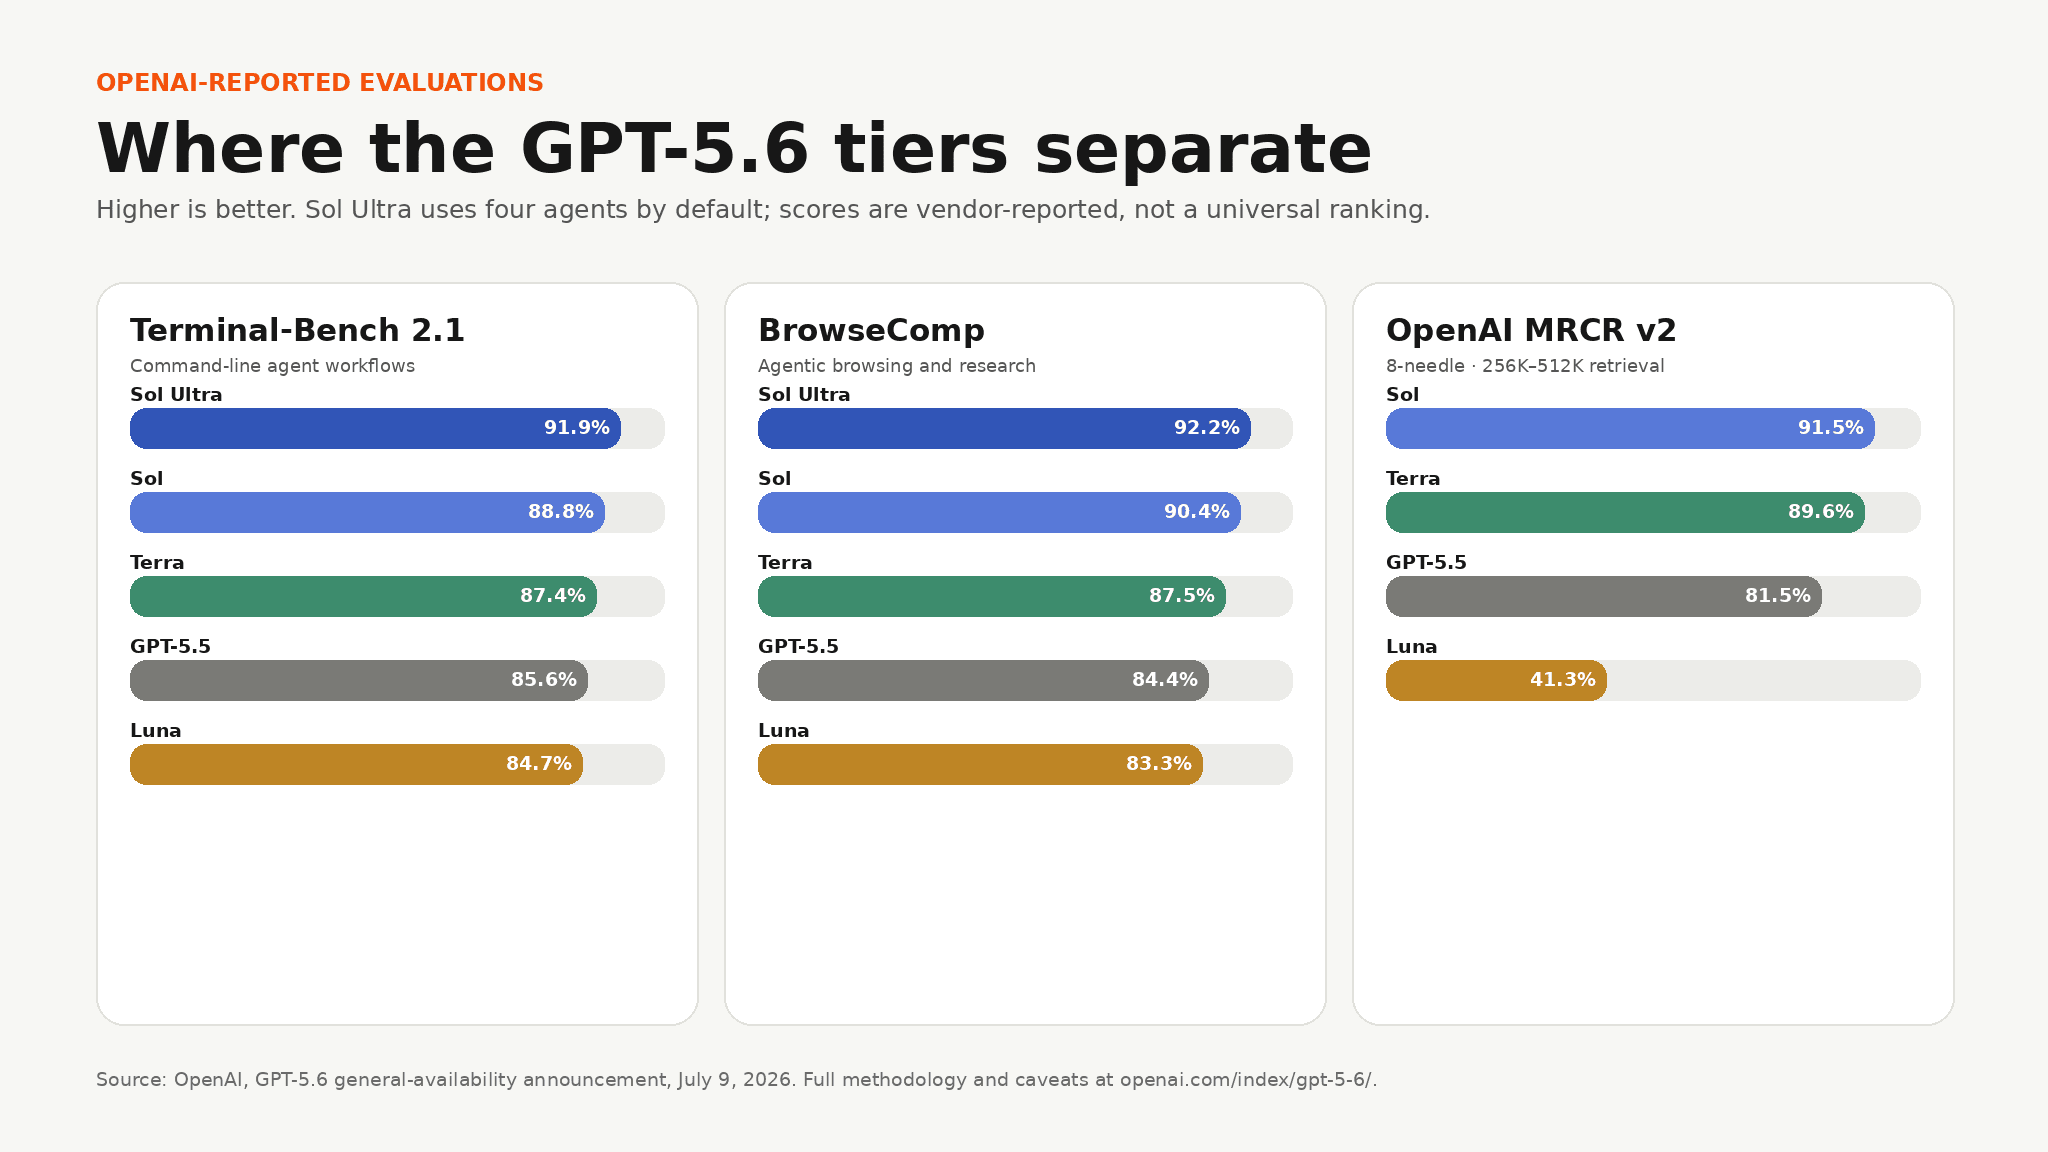
在评估命令行智能体工作流的 Terminal-Bench 2.1 上,OpenAI 报告 Sol Ultra 得分 91.9%,Sol 得分 88.8%,Terra 得分 87.4%,Luna 得分 84.7%。在 BrowseComp 上,报告得分分别为:Sol Ultra 92.2%,Sol 90.4%,Terra 87.5%,Luna 83.3%。
长上下文结果是更重要的路由信号。在 OpenAI MRCR v2、8 针、256K–512K 测试中,Sol 得分 91.5%,Terra 得分 89.6%,而 Luna 得分仅为 41.3%。Luna 在短小、重复的工作中仍然表现出色,只是不应将其视为适用于所有工作负载的"小号 Sol"。
这些均为供应商自报评估结果,并非通用排名。基准测试衡量的是特定的测试框架、工具、推理设置和预算。你自己的工作流可能会颠覆这一顺序,因此在更换生产智能体之前,请先用代表性任务重新测试。
GPT-5.6 与 GPT-5.5 及 Claude Fable 5 的对比
实际比较的问题不是"哪个模型更好?",而是"在当前运行阶段,哪种行为值得付费?"
| 模型 | 在 Zero 中的最佳适用场景 | 突出特点 | VM0 内置层级 |
|---|---|---|---|
| GPT-5.6 Sol | 规划、并行执行、设计判断或验证能够改变结果的复杂多阶段工作 | Zero 默认使用 Ultra;在编码、计算机使用、设计、研究和深度上下文方面是最强的 GPT-5.6 层级 | $$$ |
| GPT-5.6 Terra | 仍需可靠推理和工具支持的日常专业工作流 | 质量、速度和成本均衡;在长上下文工作中表现出色 | $$ |
| GPT-5.6 Luna | 输入一致、易于升级的快速高吞吐量工作 | 该系列中延迟最低、成本最低;适合分类、提取和批量处理 | $ |
| GPT-5.5 | 已验证且暂不需要重新基线化的现有 OpenAI 工作流 | 熟悉的前沿行为,是当前智能体的稳定对比基准 | 可用性取决于工作区配置 |
| Claude Fable 5 | 最深度的 Anthropic 和 Claude Code 工作流,尤其适合已针对其行为进行调优的团队 | 顶级长时程推理能力,以及独特的提供商/工具链配置 | $$$$ |
OpenAI 报告 Sol 在 Agents' Last Exam 和 Artificial Analysis Coding Agent Index 上领先 Fable 5,而 Fable 5 在 GDPval-AA v2 上仍略占优势。这正是"最佳模型"这一说法过于笼统的原因。当你需要 OpenAI 最强的智能体编码、计算机使用、设计和多智能体能力时,Sol 极具吸引力。对于顶级 Anthropic 工作以及已围绕 Claude Code 调优的工作流,Fable 仍是有效选择。
对于许多 GPT-5.5 工作负载而言,Terra 是更直接的升级候选:OpenAI 表示其性能与 GPT-5.5 相当,而 API 标价仅为后者的一半。Luna 的优化目标不同——速度与规模——因此应以每美元或每分钟完成的工作量来衡量,而非仅看峰值基准分数。
Zero 中的"内置"意味着什么
内置功能将 GPT-5.6 变为一个路由选择,而非一个凭证配置项目。选择 VM0 托管提供商,Zero 将处理访问权限,并按相应的 VM0 积分层级计费。你无需为该路由创建或维护单独的 OpenAI API 密钥。
偏好自有提供商关系的团队仍可使用 OpenAI API 密钥,或连接 ChatGPT/Codex 订阅。模型名称保持不变;计费路径和提供商配置会有所不同。VM0 积分层级($、$$、$$$)与 OpenAI 公开 API 的 token 价格并不相同。
如何在 Zero 中启用 GPT-5.6
GPT-5.6 在模型设置中选择,而非通过在提示词中写入"使用 GPT-5.6"来激活。
- 打开设置,从侧边栏选择模型。
- 在个人部分,添加 GPT 5.6 Sol、GPT 5.6 Terra 或 GPT 5.6 Luna。
- 选择内置以使用 VM0 托管路由,或选择已连接的 OpenAI API 或 ChatGPT/Codex 提供商。
- 开始对话或运行任务,打开模型选择器,切换至所需层级。
- 工作流稳定后,在智能体或技能层级设置合适的模型,确保常规工作始终使用预定路由。
实用路由手册
从以下三个问题入手:
- 错误答案的代价有多高? 当错误会带来大量返工、风险或下游影响时,使用 Sol。
- 上下文有多深、多模糊? 对于需要交叉核验和综合的大型、混乱输入,使用 Terra 或 Sol。
- 这个任务会运行多少次? 对高频、可预测的工作使用 Luna,再对异常情况进行升级。
混合路由模式值得测试:Luna 过滤并结构化输入,Terra 完成主体工作,Sol 处理少数需要最强推理的决策。你不需要一个模型包揽一切,只需让每个阶段使用足够强的模型。
GPT-5.6 让这一选择异常清晰。Sol、Terra 和 Luna 在同一智能体环境中为 Zero 提供了三个运行点——让你在工作需要时提升能力,在不需要时降低成本。