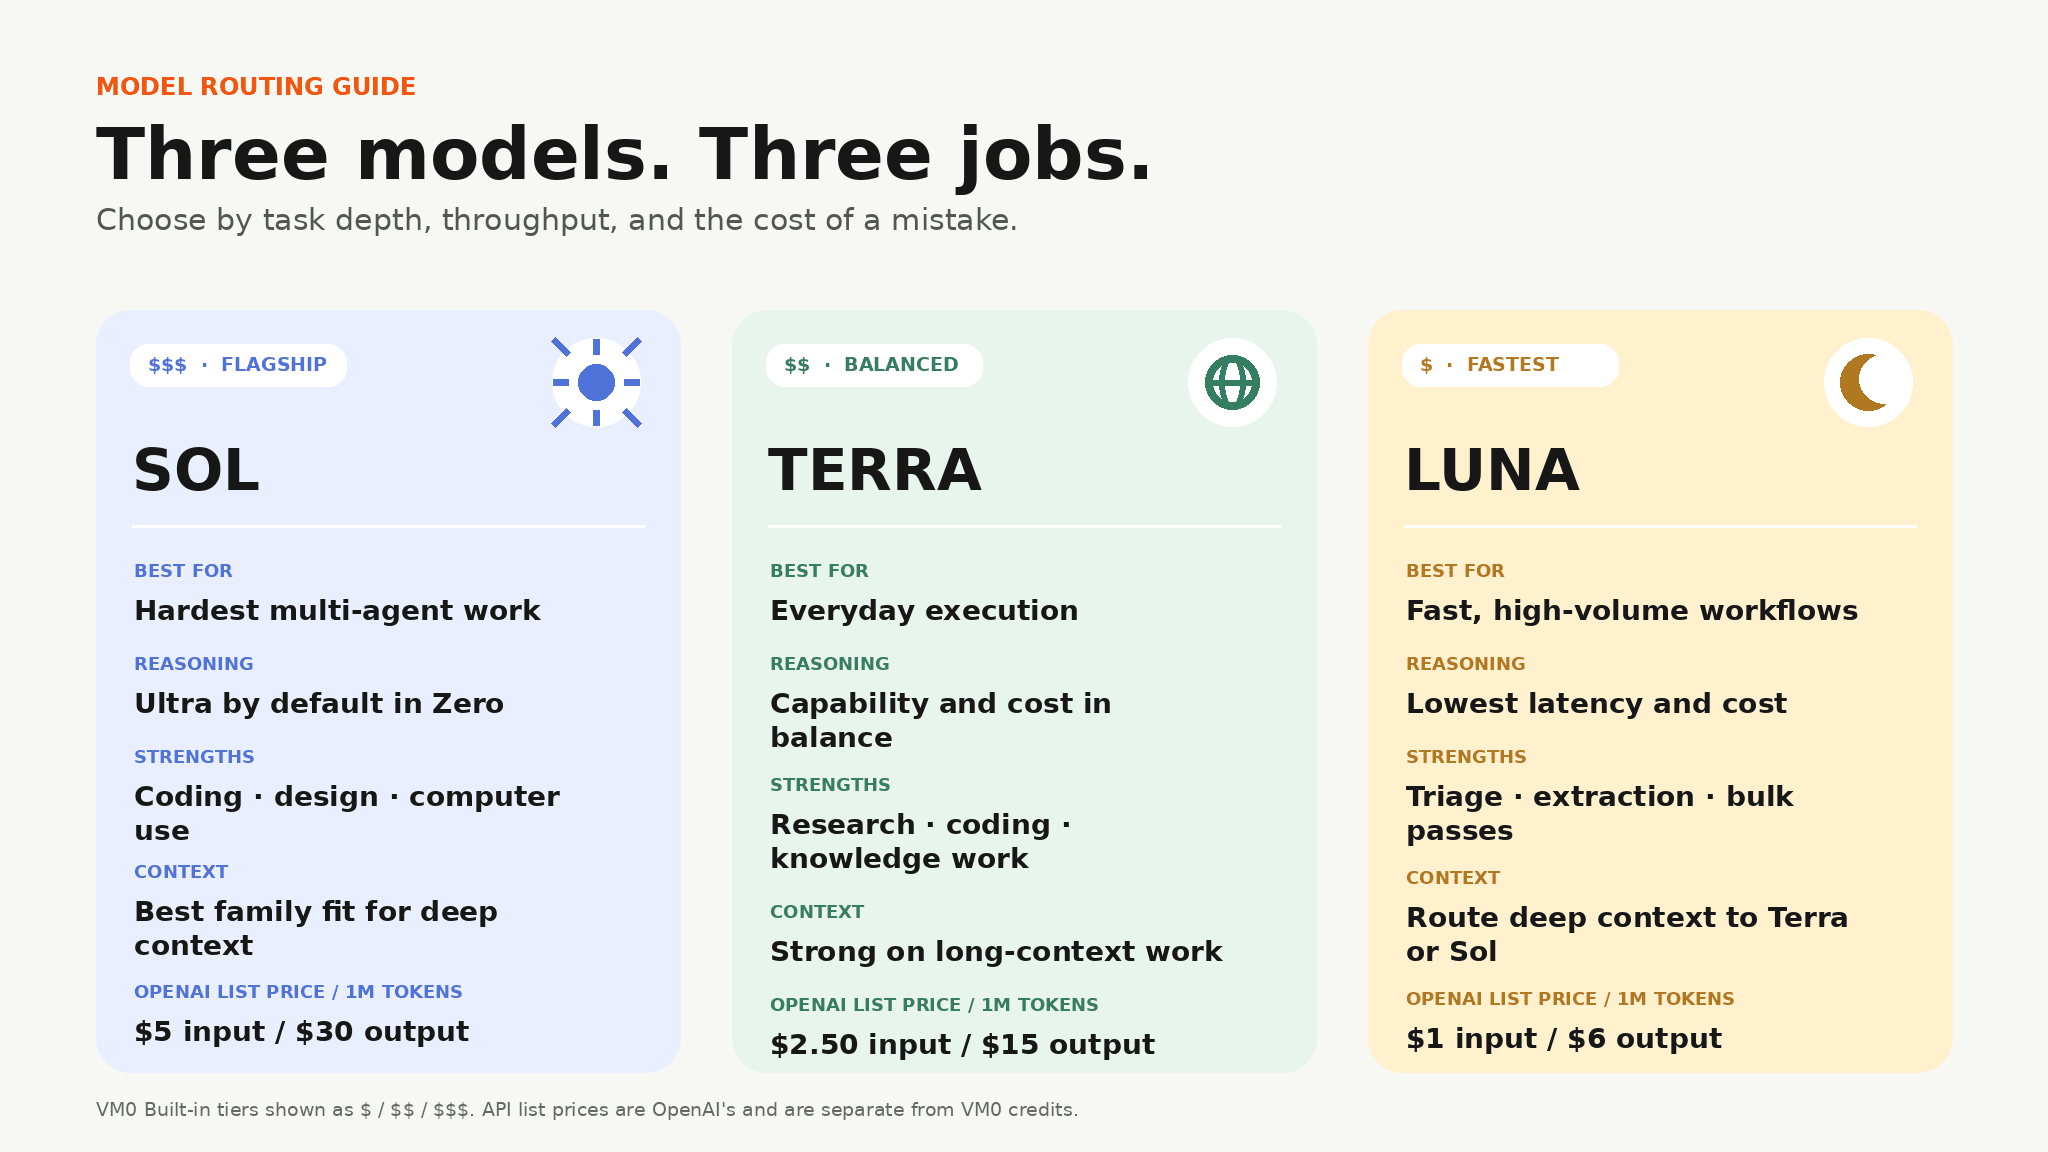
GPT-5.6 現已以三模型系列的形式內建於 Zero:Sol 適用於最艱難的多代理任務,Terra 適用於均衡的日常執行,Luna 則適用於快速、高吞吐量的工作流程。
對於需要路由多樣代理工作負載的團隊而言,這往往比單一新旗艦模型更實用。你不必在每個步驟都付出最高推理成本,而是可以根據任務選擇合適的模型,同時保留相同的 Zero 環境:連接的工具、檔案、瀏覽器存取、隔離執行、技能與後續跟進。
選擇內建路由,VM0 即可管理模型存取並以點數計費。如果你的團隊已使用 OpenAI API 金鑰或 ChatGPT/Codex 訂閱,Zero 同樣支援這些路由方式。
同一系列,三個運作點
OpenAI 以持久的能力層級為核心設計了 GPT-5.6。數字代表世代;Sol、Terra 與 Luna 則描述智能、速度與成本之間的取捨。
GPT-5.6 Sol:最艱難的任務
Sol 是旗艦模型。當任務夠困難,且更強的規劃、更多的驗證或平行作業能實質改變結果時,就應選用它。
Zero 的 GPT-5.6 Sol 整合預設使用 Ultra 推理模式。OpenAI 描述 Ultra 為協調四個代理平行運作,再整合其成果。這使 Sol 非常適合具有多個獨立工作流的任務,例如:
- 遷移大型程式碼庫,同時測試相容性並記錄結果。
- 跨多個來源進行市場研究、挑戰研究發現,並產出可供決策的簡報。
- 將產品需求文件轉化為精緻的介面,檢查渲染結果,並修正視覺或功能問題。
- 在日誌、程式碼、工單與瀏覽器狀態中調查生產事故,再提出修復方案。
Sol 對應 VM0 內建層級的 $$$。請在出錯代價高昂的場合使用它,而非用於每一個簡短回覆。
GPT-5.6 Terra:均衡的主力
Terra 是可重複執行的專業工作最合理的起點。OpenAI 將其定位為均衡層級,並表示其效能與 GPT-5.5 相當,但 API Token 定價僅為一半。
Terra 適用於仍需推理與工具使用、但不需要 Sol 最大算力的工作:
- 日常研究、競爭對手監控與多來源摘要。
- 例行程式碼變更、Pull Request 分析與問題調查。
- 起草報告、上市計畫、客戶簡報與營運文件。
- 需要強大長上下文處理能力、但成本要求較適中的代理工作流程。
Terra 對應 VM0 內建層級的 $$。它並非被強制設為通用預設;它只是我們在許多通用工作流程中會優先測試的層級。
GPT-5.6 Luna:速度與吞吐量
Luna 是系列中速度最快、成本最低的成員。它專為吞吐量與回應時間比最大深度更重要的工作而設計。
適合 Luna 的工作負載包括:
- 對大批工單、潛在客戶或訊息進行分類或路由。
- 從格式一致的文件中提取結構化欄位。
- 執行初步分類,再將模糊案例升級至 Terra 或 Sol。
- 大量產出簡短摘要或進行資料轉換。
Luna 對應 VM0 內建層級的 $。它並非所有低成本任務的正確選擇:OpenAI 自家的長上下文評估顯示,在超大輸入的檢索任務上,Luna 與另外兩個較大層級之間存在顯著差距。請將深度、模糊的上下文路由至 Terra 或 Sol。
基準測試能說明什麼——又不能說明什麼
OpenAI 在整個系列中回報了亮眼的結果,但真正有用的資訊是取捨的形態,而非單一排行榜名次。
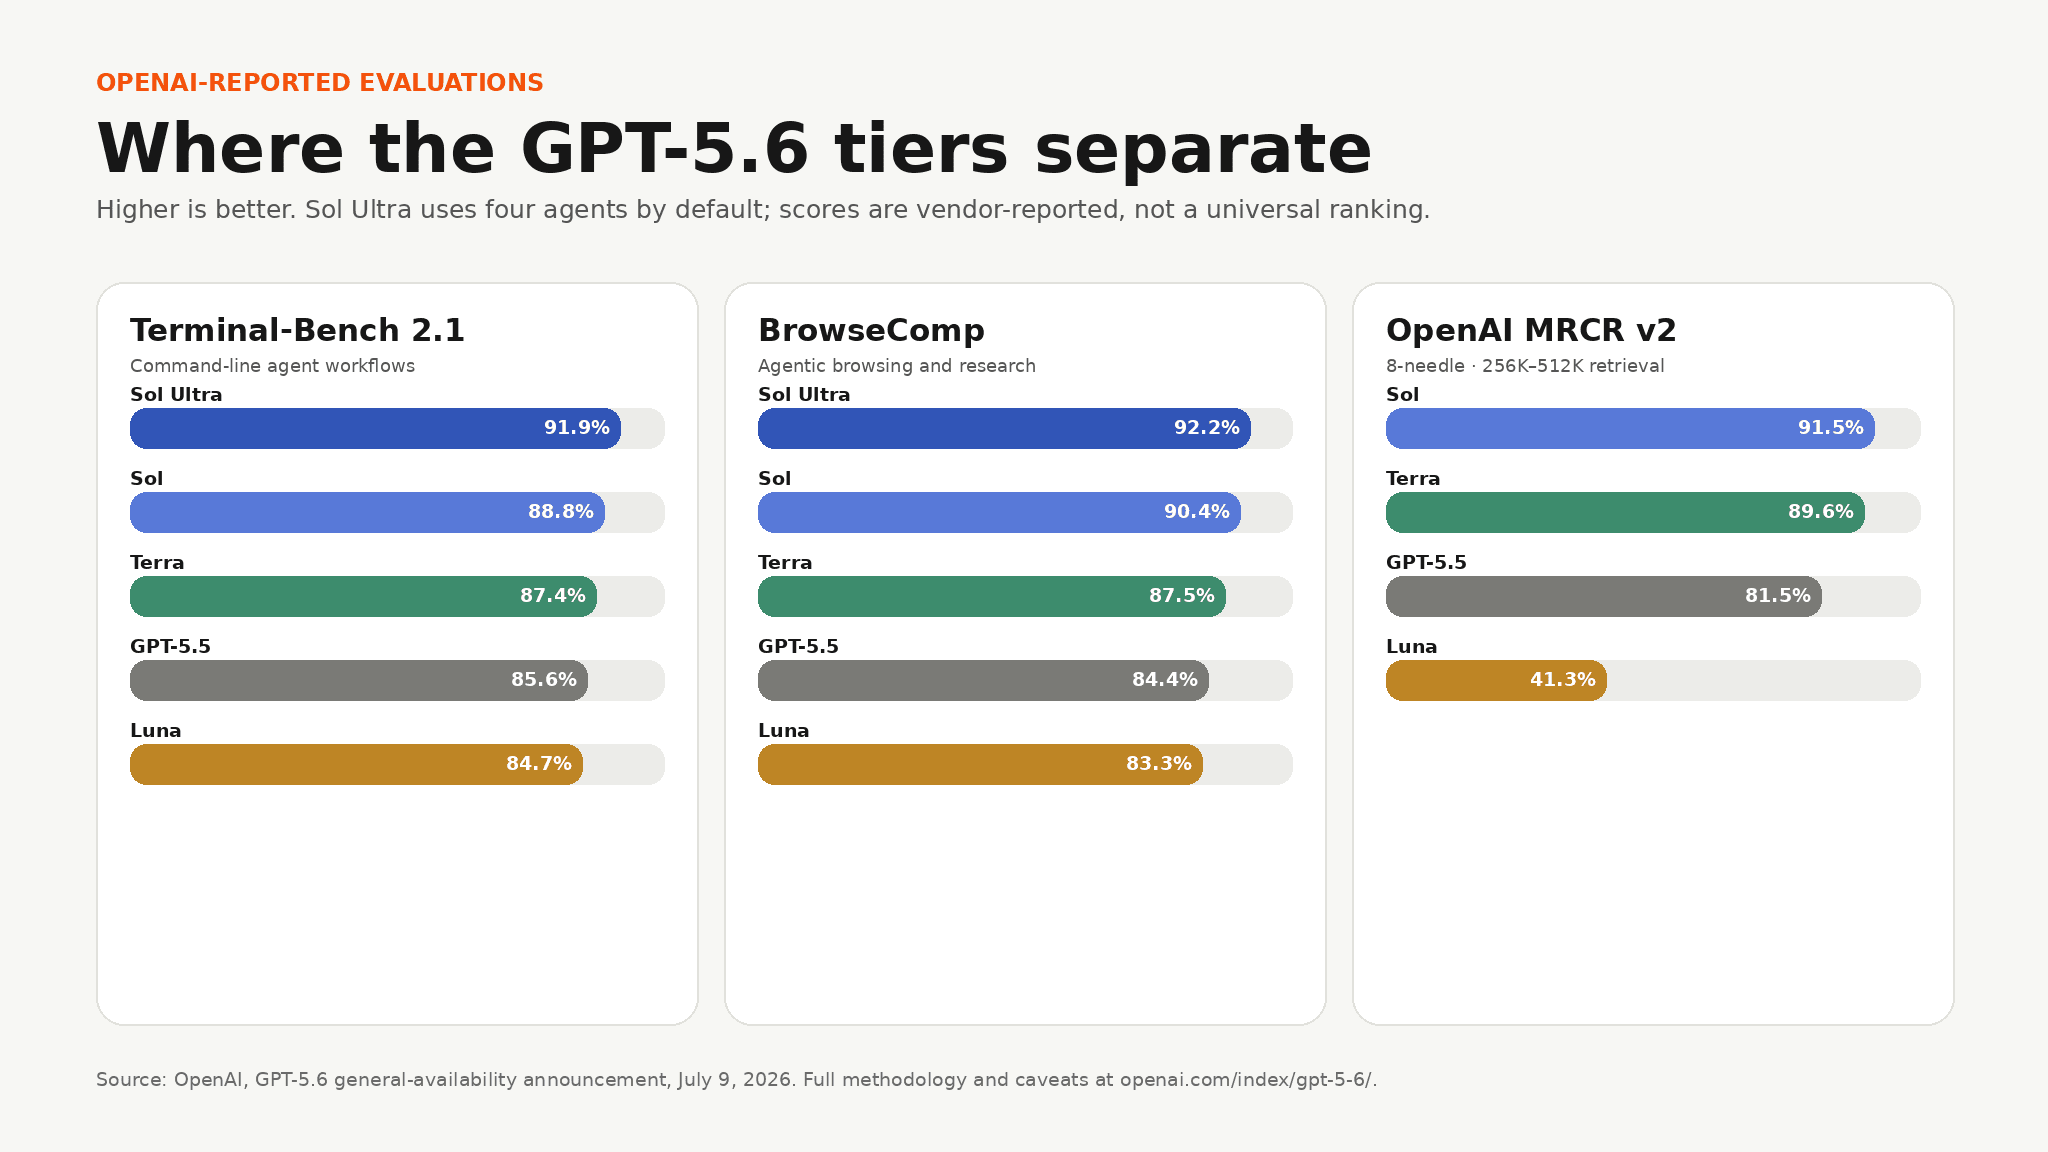
在評估命令列代理工作流程的 Terminal-Bench 2.1 上,OpenAI 回報 Sol Ultra 為 91.9%、Sol 為 88.8%、Terra 為 87.4%、Luna 為 84.7%。在 BrowseComp 上,回報分數分別為 Sol Ultra 92.2%、Sol 90.4%、Terra 87.5%、Luna 83.3%。
長上下文結果是更重要的路由訊號。在 OpenAI MRCR v2、8-needle、256K–512K 上,Sol 得分 91.5%、Terra 89.6%,而 Luna 僅得 41.3%。Luna 在短暫、重複的工作上仍可表現出色;只是不應將其視為適用於所有工作負載的小型 Sol。
這些是廠商自行回報的評估結果,並非通用排名。基準測試衡量的是特定的測試框架、工具、推理設定與預算。你自己的工作流程可能會顛覆這個順序,因此在變更生產代理之前,請先重新執行一個具代表性的任務。
GPT-5.6 vs GPT-5.5 與 Claude Fable 5
實際的比較問題不是「哪個模型最強?」,而是「在這個執行階段,哪種行為值得付費?」
| 模型 | 在 Zero 中的最佳用途 | 突出之處 | VM0 內建層級 |
|---|---|---|---|
| GPT-5.6 Sol | 規劃、平行執行、設計判斷或驗證能改變結果的艱難多階段工作 | Zero 預設使用 Ultra;在程式碼、電腦使用、設計、研究與深度上下文方面是最強的 GPT-5.6 層級 | $$$ |
| GPT-5.6 Terra | 仍需可靠推理與工具的日常專業工作流程 | 品質、速度與成本均衡;在長上下文工作中是系列內的強力選擇 | $$ |
| GPT-5.6 Luna | 輸入一致且易於升級的快速、高吞吐量工作 | 系列中延遲最低、成本最低;適合分類、提取與批次處理 | $ |
| GPT-5.5 | 已驗證且尚不需要重新建立基準的現有 OpenAI 工作流程 | 熟悉的前沿行為,以及現有代理的穩定比較基準 | 可用性取決於工作區設定 |
| Claude Fable 5 | 最深度的 Anthropic 與 Claude Code 工作流程,尤其適合已針對其行為進行調校的團隊 | 頂級的長期推理能力,以及獨特的供應商/工具生態 | $$$$ |
OpenAI 回報 Sol 在 Agents' Last Exam 與 Artificial Analysis Coding Agent Index 上領先 Fable 5,而 Fable 5 在 GDPval-AA v2 上仍略勝一籌。這正是「最佳模型」這個說法過於籠統的原因。當你需要 OpenAI 最強的代理程式碼、電腦使用、設計與多代理行為時,Sol 極具吸引力。對於頂級的 Anthropic 工作以及已針對 Claude Code 進行校準的工作流程,Fable 仍是有效的選擇。
Terra 是許多 GPT-5.5 工作負載更直接的升級候選:OpenAI 表示其效能與 GPT-5.5 相當,但 API Token 定價僅為一半。Luna 的優化目標不同——速度與規模——因此應以每美元或每分鐘完成的工作量來比較,而非僅看峰值基準分數。
「內建」在 Zero 中代表什麼
內建讓 GPT-5.6 成為路由選擇,而非憑證設定專案。選擇 VM0 Managed 供應商,Zero 即可處理存取並按對應的 VM0 點數層級計費。你不需要為該路由建立或維護獨立的 OpenAI API 金鑰。
偏好使用自有供應商關係的團隊,仍可使用 OpenAI API 金鑰或連接 ChatGPT/Codex 訂閱。模型名稱保持不變;計費路徑與供應商設定則會改變。VM0 點數層級($、$$、$$$)與 OpenAI 公開 API Token 價格並不相同。
如何在 Zero 中啟用 GPT-5.6
GPT-5.6 是在模型設定中選擇的,而非在提示詞中輸入「使用 GPT-5.6」。
- 開啟設定,從側邊欄選擇模型。
- 在個人區塊中,新增 GPT 5.6 Sol、GPT 5.6 Terra 或 GPT 5.6 Luna。
- 選擇內建以使用 VM0 Managed 路由,或選擇你已連接的 OpenAI API 或 ChatGPT/Codex 供應商。
- 開始對話或執行,打開模型選擇器,切換至你想要的層級。
- 一旦工作流程穩定,在代理或技能層級設定適當的模型,讓例行工作始終使用預定的路由。
實用路由策略手冊
從三個問題開始:
- 錯誤答案的代價有多高? 當錯誤會造成大量返工、風險或下游影響時,使用 Sol。
- 上下文有多深、多模糊? 對於需要交叉驗證與整合的大型、雜亂輸入,使用 Terra 或 Sol。
- 這個任務會執行多頻繁? 對高吞吐量、可預測的工作使用 Luna,再對例外情況進行升級。
混合路由模式值得測試:Luna 過濾並結構化輸入,Terra 完成主要工作,Sol 處理少數值得最大推理的決策。你不需要一個模型做所有事;你需要的是每個階段使用足夠的模型。
GPT-5.6 讓這個選擇變得異常清晰。Sol、Terra 與 Luna 在相同的代理環境中為 Zero 提供了三個運作點——讓你在工作需要時提升能力,在不需要時降低成本。